Qual IA tem o melhor benchmark em 2026?
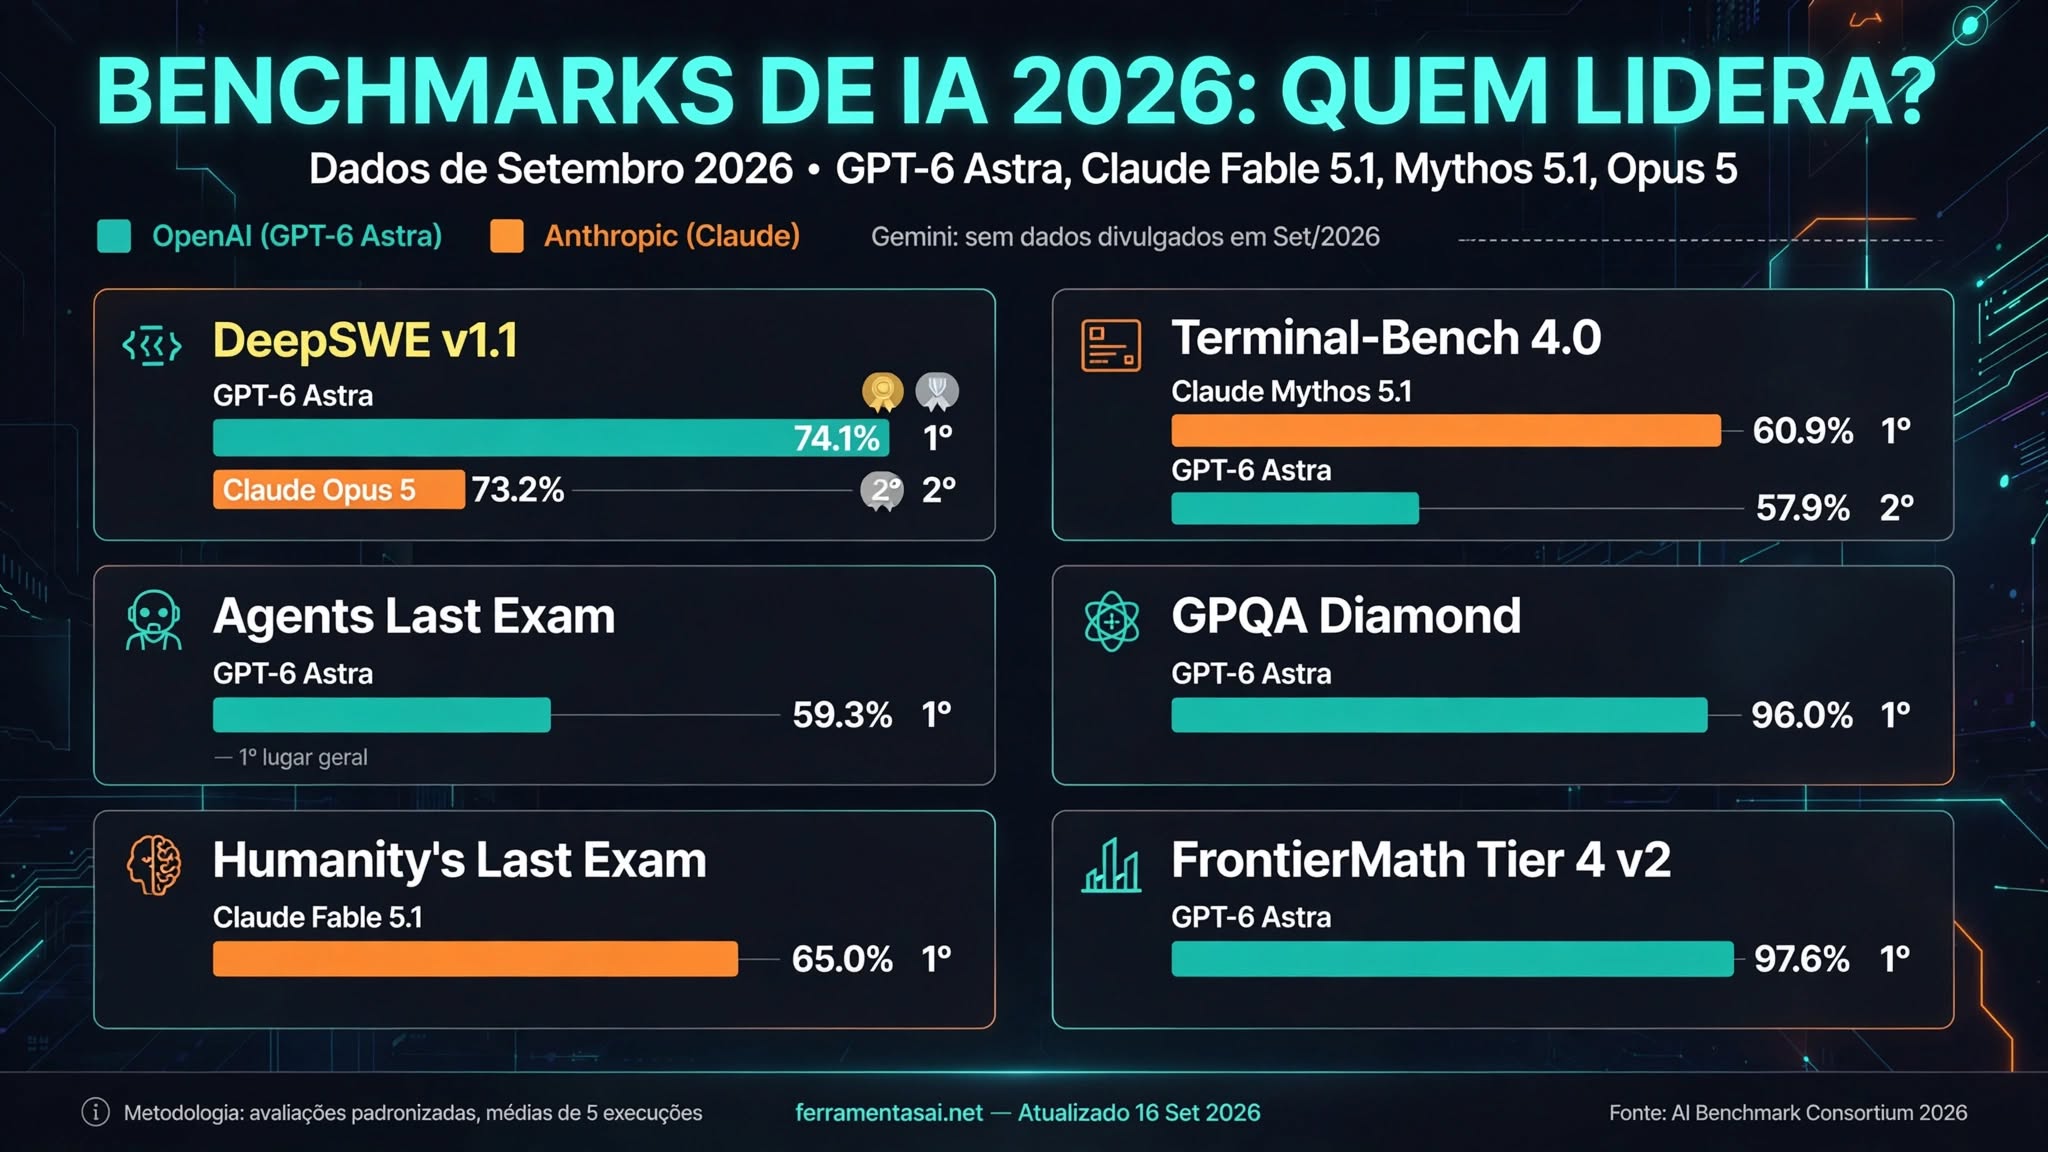
Depende da tarefa. Para ciência, matemática e programação, o GPT-6 Astra lidera (97,6% no FrontierMath, 96% no GPQA Diamond, 74,1% no DeepSWE v1.1). Para tarefas de terminal e autonomia, o Claude Mythos 5.1 lidera o Terminal-Bench 4.0 com 60,9%, e o Claude Fable 5.1 lidera o Humanity’s Last Exam com 65%.
Já não é agosto. Desde a última revisão deste artigo, a Anthropic lançou o Claude Fable 5.1 e o Claude Mythos 5.1 (1 de setembro de 2026) e a OpenAI respondeu poucos dias depois com o GPT-6 Astra (4 de setembro de 2026), o modelo que a própria OpenAI descreve como “o mais inteligente e alinhado do mundo”. Os números mudaram bastante em algumas categorias e pouco noutras. Este guia atualiza os benchmarks independentes mais seguidos com dados de setembro de 2026, para escolheres com base em números reais em vez de marketing.
Última atualização: 16 de setembro de 2026.
Programação e engenharia de software: DeepSWE v1.1
O SWE-bench Verified, durante muito tempo o benchmark de referência para “IA que programa”, está a aproximar-se da saturação nos modelos de topo (as diferenças entre os líderes já caem dentro da margem de erro do teste), por isso o DeepSWE v1.1 tornou-se a referência mais citada para medir correção de bugs reais em repositórios GitHub.
- 1º GPT-6 Astra: 74,1%
- 2º Claude Opus 5: 73,2%
- 3º Claude Fable 5.1: 67,4%
Ver a análise do que mudou no Claude Opus 5 e a review completa do Claude.
Tarefas de terminal e agentes: Terminal-Bench 4.0
Testa se o modelo consegue usar um terminal para editar ficheiros, correr comandos e depurar código de forma autónoma, sem supervisão passo a passo.
- 1º Claude Mythos 5.1: 60,9%
- 2º GPT-6 Astra: 57,9%
- 3º Claude Fable 5.1: 55,8%
O Claude Opus 5 fica fora do pódio nesta versão do benchmark, com 52,3%.
Autonomia em tarefas de agente: Agents’ Last Exam
O METR Time Horizons, que liderava esta categoria em agosto (o Claude Mythos Preview completava sozinho tarefas de mais de 17 horas), ainda não teve uma atualização pública comparável desde então. O benchmark mais citado agora para autonomia de agentes em tarefas profissionais é o Agents’ Last Exam, lançado junto com o GPT-6 Astra:
- 1º GPT-6 Astra: 59,3%
- 2º Claude Opus 5: 55,5%
- 3º GPT-5.6 Sol: 53,6%
Nota de cautela: ao contrário dos outros benchmarks deste artigo, os números da Anthropic e do GPT-5.6 Sol neste teste específico vêm de uma única fonte secundária (não da própria Anthropic), por isso vale tratar estes dois com uma reserva extra até haver confirmação independente. O número do GPT-6 Astra é o único confirmado diretamente pela OpenAI.
Ciência e raciocínio: GPQA Diamond
198 perguntas de nível doutoramento em biologia, química e física, onde adivinhar ao acaso só acerta cerca de 25%.
O GPT-6 Astra lidera com 96,0%, a pontuação mais alta já publicada neste teste, confirmada diretamente pela OpenAI. Os restantes modelos de topo (Claude Fable 5.1, Claude Opus 5, Gemini) ficam todos entre 92,6% e 96,0%, uma diferença pequena que deixa a ordem exata entre eles dentro da margem de erro do teste.
Ver a review completa do Gemini.
Conhecimento e raciocínio mais difícil: Humanity’s Last Exam
2.500 perguntas multidisciplinares desenhadas para serem o teste mais duro que existe hoje para modelos de IA. Nesta versão, o acesso a ferramentas (pesquisa, execução de código) é permitido durante o teste.
- 1º Claude Fable 5.1: 65,0%
- 2º Claude Opus 5: 63,6% (dado preliminar, ainda com poucas fontes independentes a confirmar)
- 3º GPT-6 Astra: 57,2%
Matemática avançada: FrontierMath
Problemas de matemática ao nível de investigação, escritos por especialistas e nunca publicados, para evitar que o modelo já os tenha “visto” em treino. A versão atual (Tier 4, v2) é mais difícil do que a usada na revisão anterior deste artigo, por isso as pontuações não são diretamente comparáveis com as de agosto.
- 1º GPT-6 Astra: 97,6%
- 2º Claude Fable 5.1 (empatado com o Claude Fable 5): 87,8%
- 3º Claude Opus 5: 73,2%
O aviso que ninguém dá: os líderes do ranking não são os que usas
Repara nas etiquetas: “Tier 4”, “com ferramentas”, “v2”. São variantes e configurações de teste com muito mais tempo, ferramentas ou poder de computação por resposta do que a versão que abre por defeito no ChatGPT, Claude ou Gemini que pagas mensalmente. O GPT-6 Astra, em particular, custa 10 a 50 dólares por milhão de tokens (entrada/saída), um preço de nível empresarial, bem acima do que pagas num plano de consumidor. Um benchmark que lidera com “GPT-6 Astra” ou “Claude Fable 5.1 (com ferramentas)” não te diz como a IA se comporta no teu plano de 20 dólares/mês. Antes de escolheres com base num número de topo de tabela, confirma se essa variante está mesmo acessível no teu plano.
Benchmarks de IA: Então Qual Escolher?
Nos benchmarks de IA, depende sempre da tarefa, não de qual modelo “ganha” no geral:
- Raciocínio geral e trabalho de agente sustentado: Claude Fable 5.1, o modelo com a pontuação mais alta no Artificial Analysis Intelligence Index desde o lançamento. Ver o que mudou no Claude Opus 5 e a review do Claude.
- Ciência, matemática avançada e investigação: GPT-6 Astra, o líder mais consistente nos testes mais difíceis (GPQA Diamond, FrontierMath).
- Programação e correção de bugs reais: GPT-6 Astra e Claude Opus 5 empatados no topo do DeepSWE; para tarefas de terminal e configuração de ambiente, o Claude Mythos 5.1 lidera.
- Orçamento apertado: vale a pena olhar para a DeepSeek, que continua a entregar performance próxima dos líderes por uma fração do preço.
Para uma comparação lado a lado dos modelos gratuitos, o post ChatGPT vs Gemini vs DeepSeek: Qual a Melhor IA Grátis cobre isso em detalhe, e o Guia Completo por Categoria ajuda a escolher fora do universo dos chatbots gerais.
Nota: benchmarks de IA mudam a cada poucas semanas com o lançamento de novos modelos, e esta é já a segunda revisão deste artigo desde a publicação original. Os dados acima são de setembro de 2026 (Claude Fable 5.1 e Claude Mythos 5.1 lançados a 1 de setembro; GPT-6 Astra lançado a 4 de setembro, verificado a 16 de setembro de 2026). Para os números mais recentes, consulta diretamente as fontes abaixo ou o LM Council.
Sources:
– OpenAI: GPT-6 Astra (benchmarks oficiais)
– Anthropic: System Card: Claude Fable 5.1 e Claude Mythos 5.1
– LM Council: AI Model Benchmarks (dados Epoch AI e Scale AI)
– Epoch AI: Terminal-Bench
– Epoch AI: GPQA Diamond
– Scale AI: Humanity’s Last Exam
– Epoch AI: FrontierMath
